📌 개요
🔑 학습 키워드
┗ 리스트 슬라이싱: 리스트이름[시작 인덱스: 끝 인덱스: 간격]
┗ 리스트 컴프리헨션: 반복문을 이용해서 새로운 리스트를 간결하게 만드는 문법
┗ 딕셔너리 컴프리헨션: 반복문을 이용해서 새로운 딕셔너리를 간결하게 만드는 문법
┗ 문자열 형식 지정: C 스타일, str.format(), f-문자열 포맷팅
┗ 컨텍스트 관리: with => 자원 사용 후 close 등 자동 관리 문법
💡 1. 시퀀스 슬라이싱과 컴프리헨션
[ 리스트 슬라이싱 ]
┗ 대상 리스트의 "부분 리스트"를 "생성" 또는 "수정"하는 문법
┗ 문법 형식:
- 리스트이름[시작 인덱스:끝 인덱스:간격]┗ 예제:
< '예제' >
numbers = [10, 20, 30, 40, 50, 60, 70]

(1) '끝 인덱스'
subset1 = numbers[ :3]
인덱스   0   1   2   3   4   5   6
값      10  20  30  40  50  60  70
        └───────┘
- '결과': 10, 20, 30
-> 시작 인덱스 지정이 없으면 0부터 -> 끝 인덱스 3이므로 10, 20, 30 부분 리스트 생성
-> 참고로 끝 인덱스 3은 포함을 하지 않으며, 간격 지정이 없을 땐 0임

(2) '시작 인덱스, 음수'
subset2 = number[-3: ]
양수:   0   1   2   3   4   5   6
값:    10  20  30  40  50  60  70
음수:  -7  -6  -5  -4  -3  -2  -1
-> 음수는 리스트 뒤에서부터 시작 끝 인덱스는 없으므로 리스트의 끝인 6까지 진행
- '결과': 50, 60, 70

(3) '간격'
list1 = numbers[ : : 2 ]
인덱스   0   1   2   3   4   5   6
값      10  20  30  40  50  60  70
        └──────┘└───────┘└──────┘
-> 간격 2 = 2칸씩 이동
- '결과': 10, 30, 50, 70

list2 = numbers[ : : -1 ]
양수:   0   1   2   3   4   5   6
값:    10  20  30  40  50  60  70
음수:  -7  -6  -5  -4  -3  -2  -1
-> 간격 -1 음수인 경우 진행 방향 뒤에서부터 진행
- '결과': 70, 60, 50, 40, 30, 20, 10
[ 리스트 컨프리헨션 ]
┗ 반복문을 이용해서 새로운 리스트를 간결하게 만드는 문법
┗ 문법 형식:
- '문법형식1': [표현식 for 변수 in 반복가능한 객체]
- '문법형식2': [표현식 for 변수 in 반복가능한 객체 if 조건]
- '반복가능한 객체': 리스트, 튜플, 딕셔너리, 문자열, 집합, range 객체
┗ 예제:
< '기존 방식' >
numbers = []
for i in range(5):
    numbers.append(i)
print(numbers) => 0, 1, 2, 3, 4

< '컴프리헨션' >
numbers = [ i for i in range(5) ]
print(numbers) => 0, 1, 2, 3, 4
┗ 리스트 컴프리헨션 응용:
(1) '원소 조작'
numbers = [1, 2, 3, 4, 5]
squares = [num ** 2 for num in numbers]
print(squares) => 1, 4, 9, 16, 25
-> num ** 2 을 통해 각 원소의 제곱을 통해 원소 조작

(2) '조건 적용'
numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
even_numbers= [num for num in numbers if num % 2 == 0]
print(even_numbers) => 2, 4, 6, 8, 10
-> if 조건을 통해 짝수인 경우 true -> true 인 경우에만 원소 삽입
[ 딕셔너리 컨프리헨션 ]
┗ 반복문을 이용해서 새로운 딕셔너리를 간결하게 만드는 문법
┗ 문법 형식:
- '문법형식1': {키: 표현식 for 변수 in 반복가능객체}
-> 배열과 같은 반복가능객체를 통해 각 요소의 값을 키로 쓰고 표현식의 결과를 값으로 씀
- '문법형식2': {키: 표현식 for 키변수, 값변수 in 딕셔너리.items()}
-> 이미 존재하는 딕셔너리를 반복가능객체로 쓰는 경우임
-> 딕셔너리.items() = 각각의 키와 값을 한 쌍으로 가져오는 함수
┗ 예제:
< '문법형식1 기존 문법' >
squares = {}
for i in range(5):
    squares[i] = i ** 2
print(squares) => '0, 1, 4, 9, 16'

< '문법형식1: 딕셔너리 컴프리헨션 문법' >
squares = {i: i ** 2 for i in range(5)}
print(squares) => '0, 1, 4, 9, 16'

< '문법형식2 기존 문법' >
new_scores = {}
for name, score in scores.items():
    new_scores[name] = score + 10
print(new_scores) => '{"홍길동": 90,"김철수": 100,"이영희": 80}'

< '문법형식2: 딕셔너리 컴프리헨션 문법' >
scores = {"홍길동": 80,"김철수": 90,"이영희": 70}
new_scores = {name: score + 10 for name, score in scores.items()}
print(new_scores) => '{"홍길동": 90,"김철수": 100,"이영희": 80}'
-> scores.items() 를 통해 기존 딕셔너리를 반복가능객체로 활용
💡 2. 문자열 형식 지정
[ 문자열 형식 지정의 개념 ]
┗ 데이터 분석 과정에서 특정 형식의 데이터를 출력
┗ 변수 값을 포함한 문자열을 생성하는 상황이 자주 발생
┗ 파이썬 포맷팅 스타일 종류:
- C 스타일(%) 포맷팅
- str.format() 메서드 활용 포맷팅
- f-string 포맷팅
[ C 스타일(% 연산자) 포맷팅 ]
┗ C 언어의 printf() 스타일과 유사
┗ C 스타일 포맷팅 문법형식:
- "형식 지정자를 포함한 문자열" %(변수 리스트)
- 'Python 문법 예시': print("상품명: $s, 가격: %d" % (item, price))
┗ C 스타일의 단점:
- 변수의 개수가 증가할수록 복잡해지고 가독성이 저하
- 변수의 개수가 잘못되거나 순서 불일치 시 오류 발생
- 딕셔너리, 리스트 등 중첩된 데이터 구조를 직접 활용하기 어려움
┗ 주요 형식 지정자:
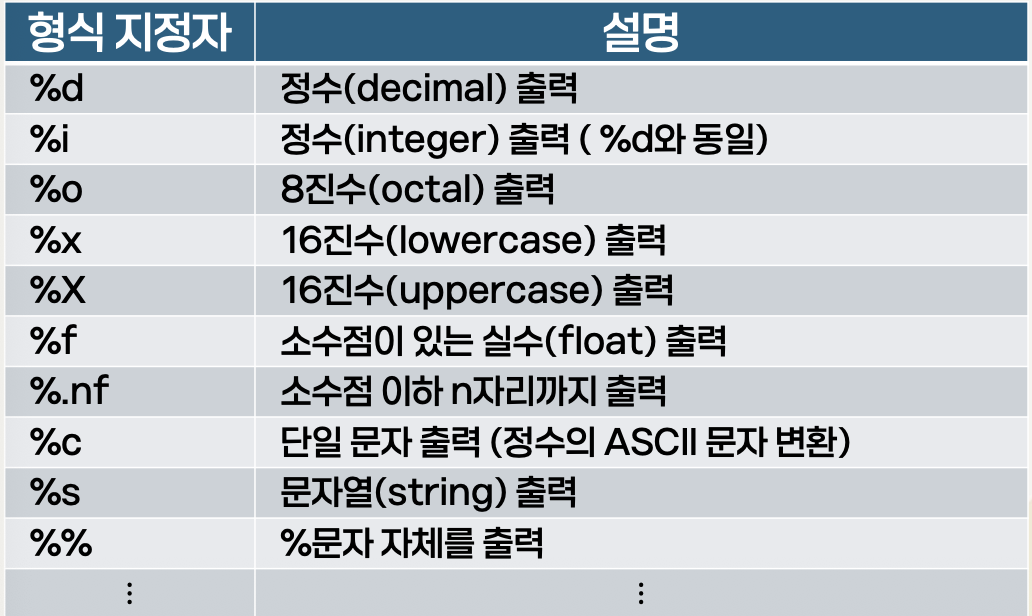
┗ C 스타일 포맷팅 활용 예(Python):
item = "프린터"
price = 360000
print("상품명: %s, 가격: %d" % (item, price))
[ str.format() 메서드 활용 ]
┗ 중괄호 내에는 공백, 인덱스, 키워드 또는 속성 이름을 지정
┗ 형식 지정자를 통해 정렬, 패딩, 소수점 자릿수, 천 단위 구분자 등 출력 형식을 지정
<'공백 중괄호'>
basic_format = '이름: {}, 나이: {}, 월급: {}원'.format(name, age, salary)

<'인덱스'>
index_format = '직원 {0}의 나이는 {1}세이고, {0}의 세후 월급은 {2}원 입니다.'
    .format(name, age, int(salary * (1 - tax_rate)))

<'키워드'>
keyword_format = '이름: {employee}, 나이: {years}세'.format(employee=name, years=age)
[ f-문자열 ]
┗ 파이썬 3.6 버전부터 도입된 문자열 포맷팅 방식
┗ 문자열 앞에 'f' 또는 'F' 접두사를 붙이고, 문자열 내부에 중괄호({})를 사용하여 변수나 표현식을 표현
┗ 직관적 표현으로 코드의 길이가 줄고 가독성 향상
┗ f-문자열 포맷팅 문법형식:
f"문자열 {표현식}"

name = "홍길동"
age = 30
print(f"이름: {name}, 나이: {age}")
┗ 예제:
basic_format = f'이름: {name}, 나이: {age}, 월급:
                {salary}원'
index_format = f'직원 {name}의 나이는 {age}세이고,
                {name}의 세후 월급은 {int(salary *
                (1 - tax_rate))}원입니다.'
keyword_format = f'직원정보: 이름: {name} 나이:
                {age}세 월급: {salary:,}원 세금:
                {tax_rate:.1%} 실수령액:
                {int(salary * (1 - tax_rate)):,}원'
💡 3. 컨텍스트 관리
[ 리소스의 사용 ]
┗ 리소스는 획득 및 사용 후 명시적으로 폐기
┗ 자원 사용 예제:
file = open("output.txt", "w")
file.write("Hello, world!\n")
3 file.close()
[ 컨텍스트 관리 ]
┗ 자원을 효율적이고 안전하게 사용할 수 있도록 하는 메커니즘
┗ 즉, 자원 사용 후 명시적으로 폐기해 주어야 하는 자원의 획득과 해제를 자동으로 처리
┗ "with" 키워드 사용:
<'기존 방식'>
file = open("output.txt", "w")
file.write("Hello, world!\n")
file.close()

<'with 키워드 방식'>
with open("output.txt", "w") as file:
file.write("Hello, world!\n")'방송통신대학교 > 📊 오픈소스기반 데이터분석' 카테고리의 다른 글
| [오픈소스기반 데이터분석] 3강 - 데이터 분석을 위한 파이썬 프로그래밍(2) (0) | 2026.09.25 |
|---|---|
| [오픈소스기반 데이터분석] 1강 - 데이터분석과 오픈소스 (0) | 2026.09.17 |